擷取文字的結果有錯字,或沒有任何內容
ZunShot 使用 Windows 內建的 OCR 引擎。辨識結果取決於已安裝的辨識語言和圖片品質。
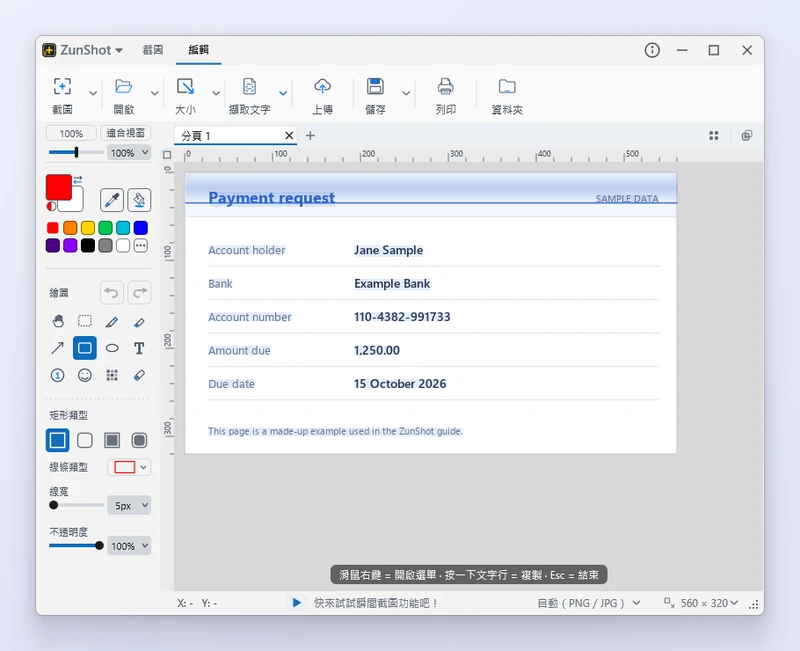
出現亂碼
辨識語言與文字不符。請在擷取文字面板中選擇正確的語言。如果清單中沒有該語言,請加以安裝:「設定 > 語言」 > 安裝 OCR 語言…。
已安裝語言,但 OCR 仍然失敗
Windows 只有在安裝了該語言的基本鍵入功能時才會註冊 OCR 引擎,只安裝顯示語言是不夠的。開啟 Windows 的「設定 > 時間與語言 > 語言與地區」,選擇該語言,然後新增「基本鍵入」。
無法辨識任何文字
- 放大截圖,讓文字高度至少約 20 像素,然後重新擷取文字。
- 裁剪掉文字周圍的相片和圖示。
- 經過高度壓縮或使用藝術字型的文字可能無法辨識。
詳細說明請參閱使用指南:擷取文字(OCR)。
快速解答
- 為什麼 OCR 會辨識出亂碼?
- 所選的語言與文字不符。請選擇或安裝正確的 Windows OCR 語言。
- 進行 OCR 時會上傳我的圖片嗎?
- 不會。辨識是使用 Windows OCR 引擎在電腦本機上進行的。